S / 01 · SPEECH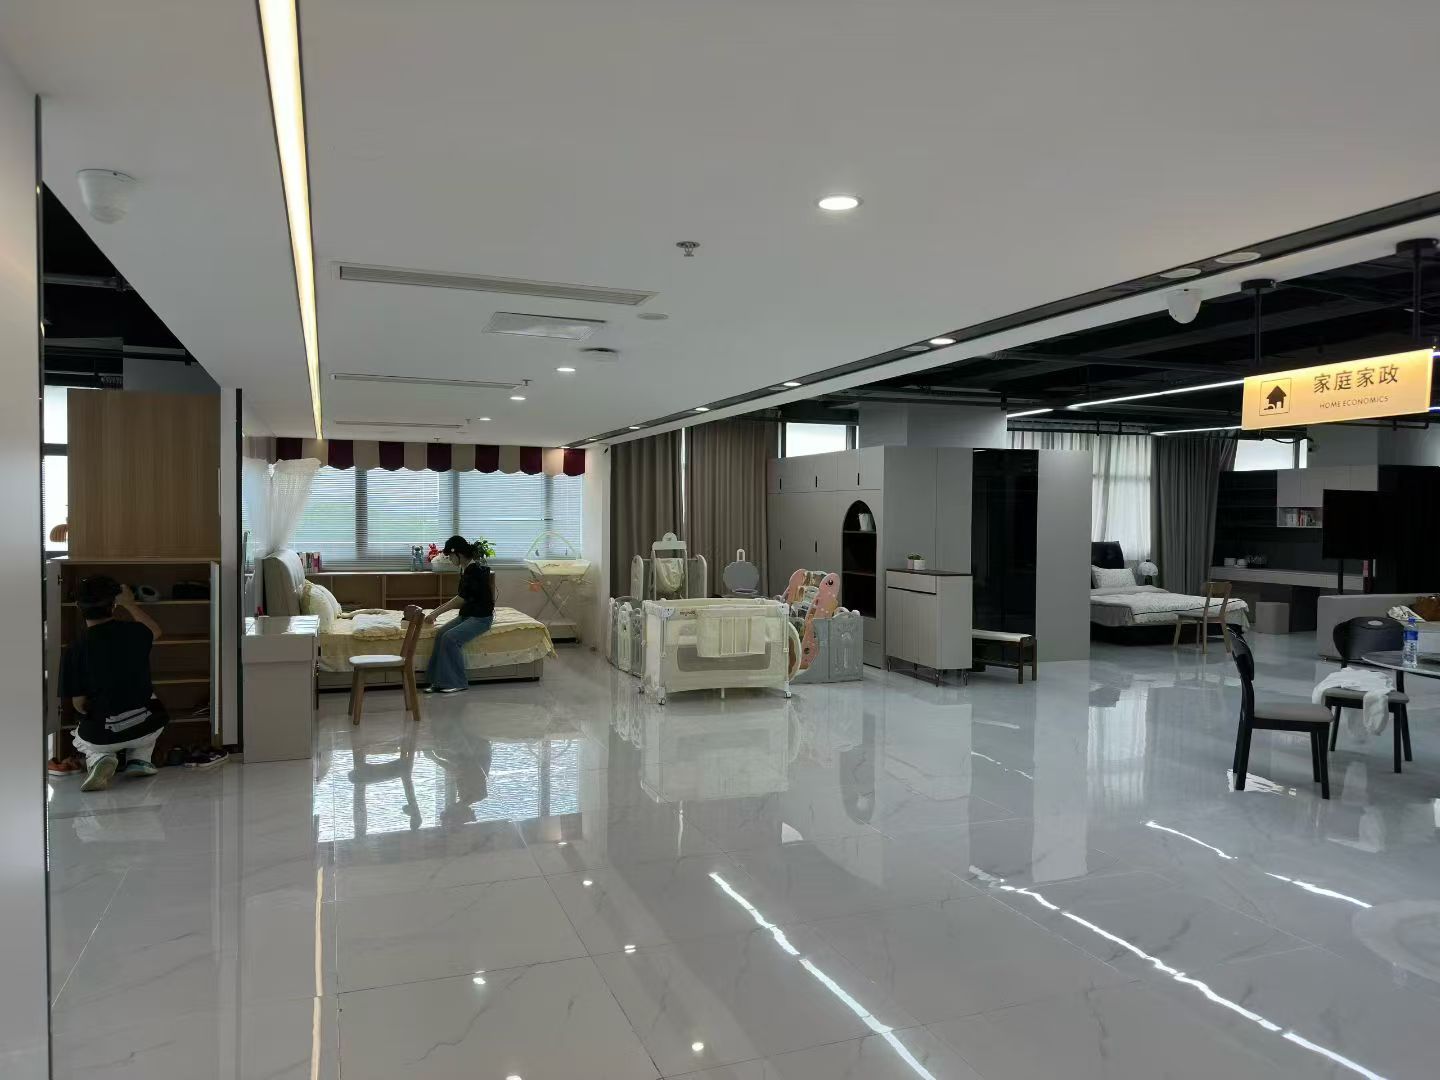
声音采集 + 标注
多语种 · 多方言的语音数据底座
面向语音大模型、语音交互与本地化场景,提供多语种、多方言的语音数据采集与逐句精细化标注。
- 类型朗读 · 命令词 · 唤醒词 · 双人对话 · 电话信道 · 远场嘈杂
- 交付音频 + 逐句转写文本 + 时间戳 + 说话人分离(待修改)
- 覆盖12 种语言 + 13 种方言
- 应用方言识别 · 客服 · 车载 · 智能家居 · 小语种 · 跨境翻译
R / 02 · EMBODIED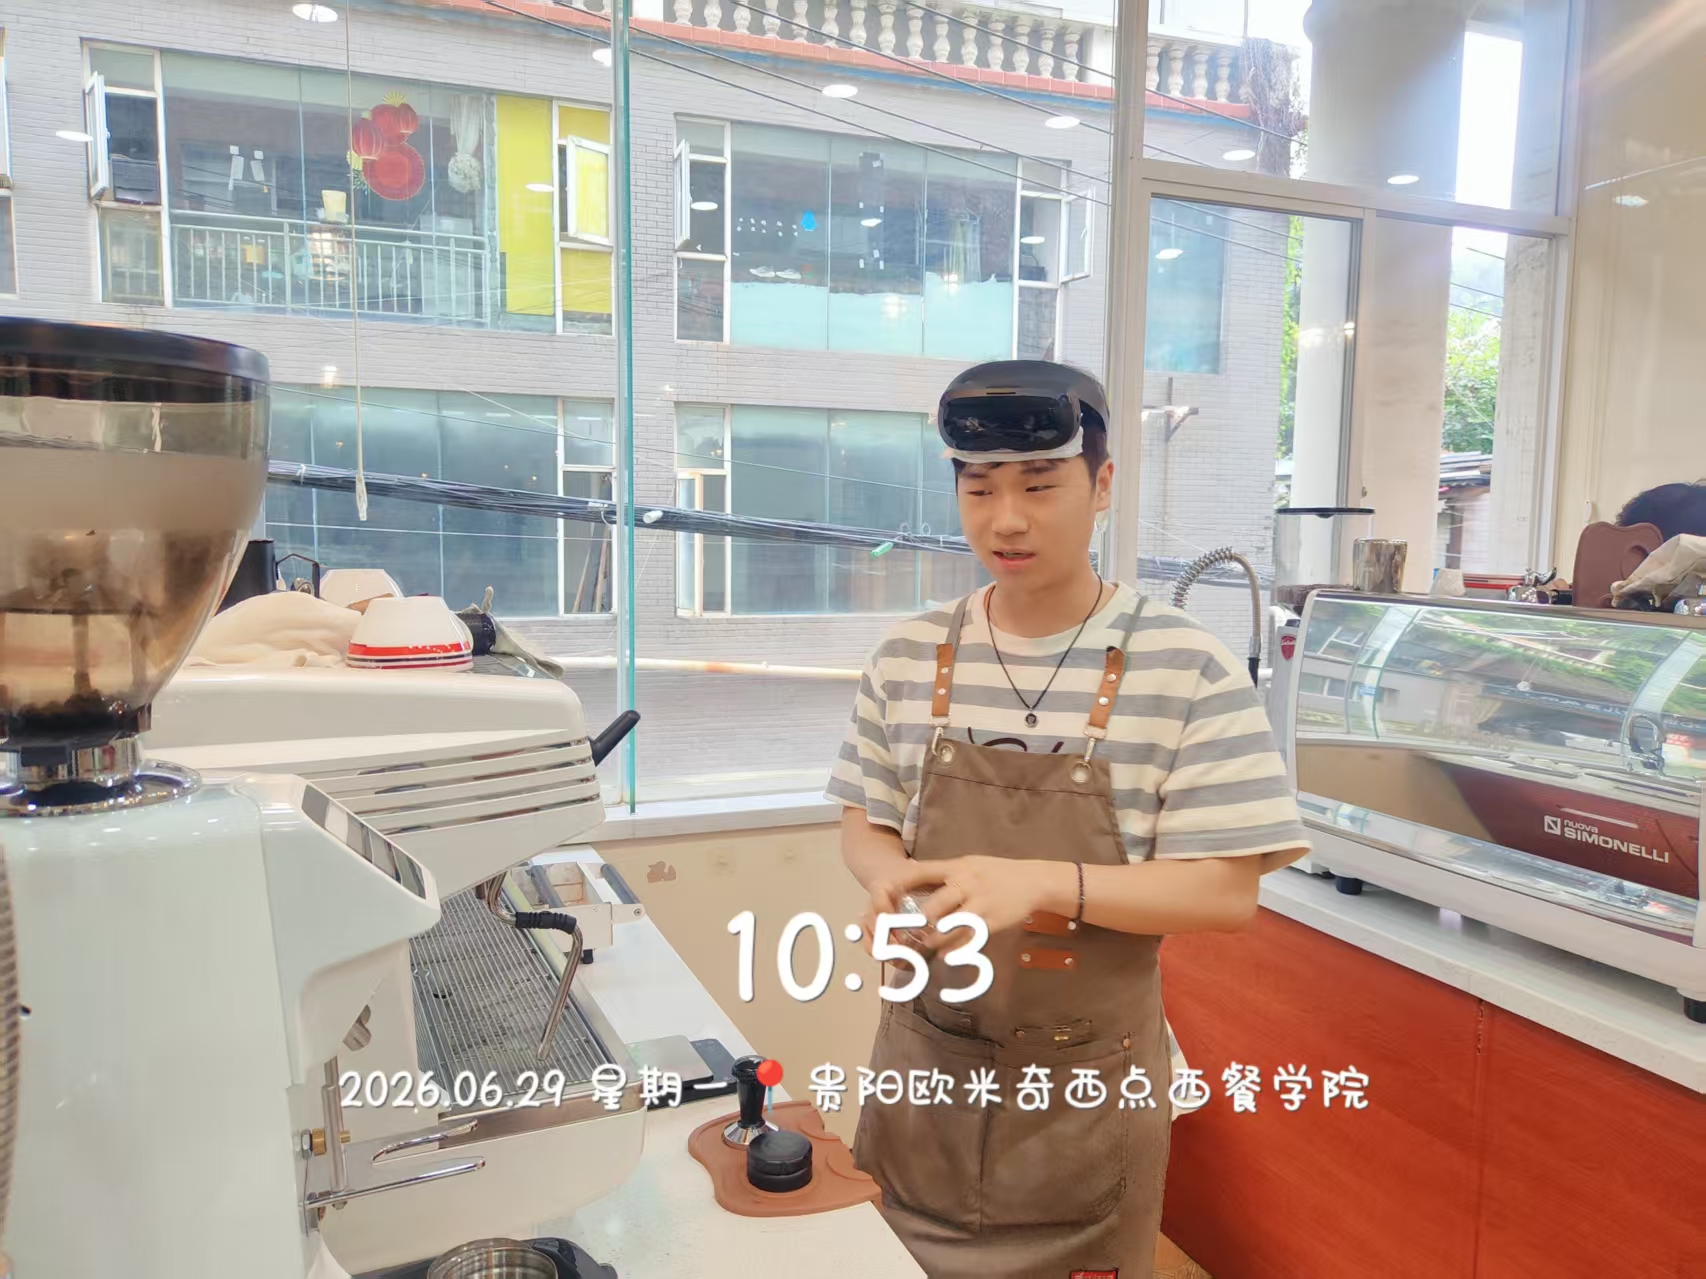
具身智能采集 + 标注
把人的操作,录成可训练的时间序列
面向人形机器人 / 具身大模型,围绕真实世界的操作与交互,进行感知—动作—语言时序绑定的采集与标注。
- 五类精细化手部姿态 · 多模态手部交互 · 第一人称视角 · 全身协同 · 长序列任务
- 设备双目 ego 采集设备 · UMI · PICO · RGB/Depth/IMU/触觉
- 场景工业制造 · 商业服务 · 家庭服务 · 公共服务 · 30+ 实景
- 网络川渝黔陕鲁属地化 · 成都 / 贵阳双基地
M / 03 · ADAS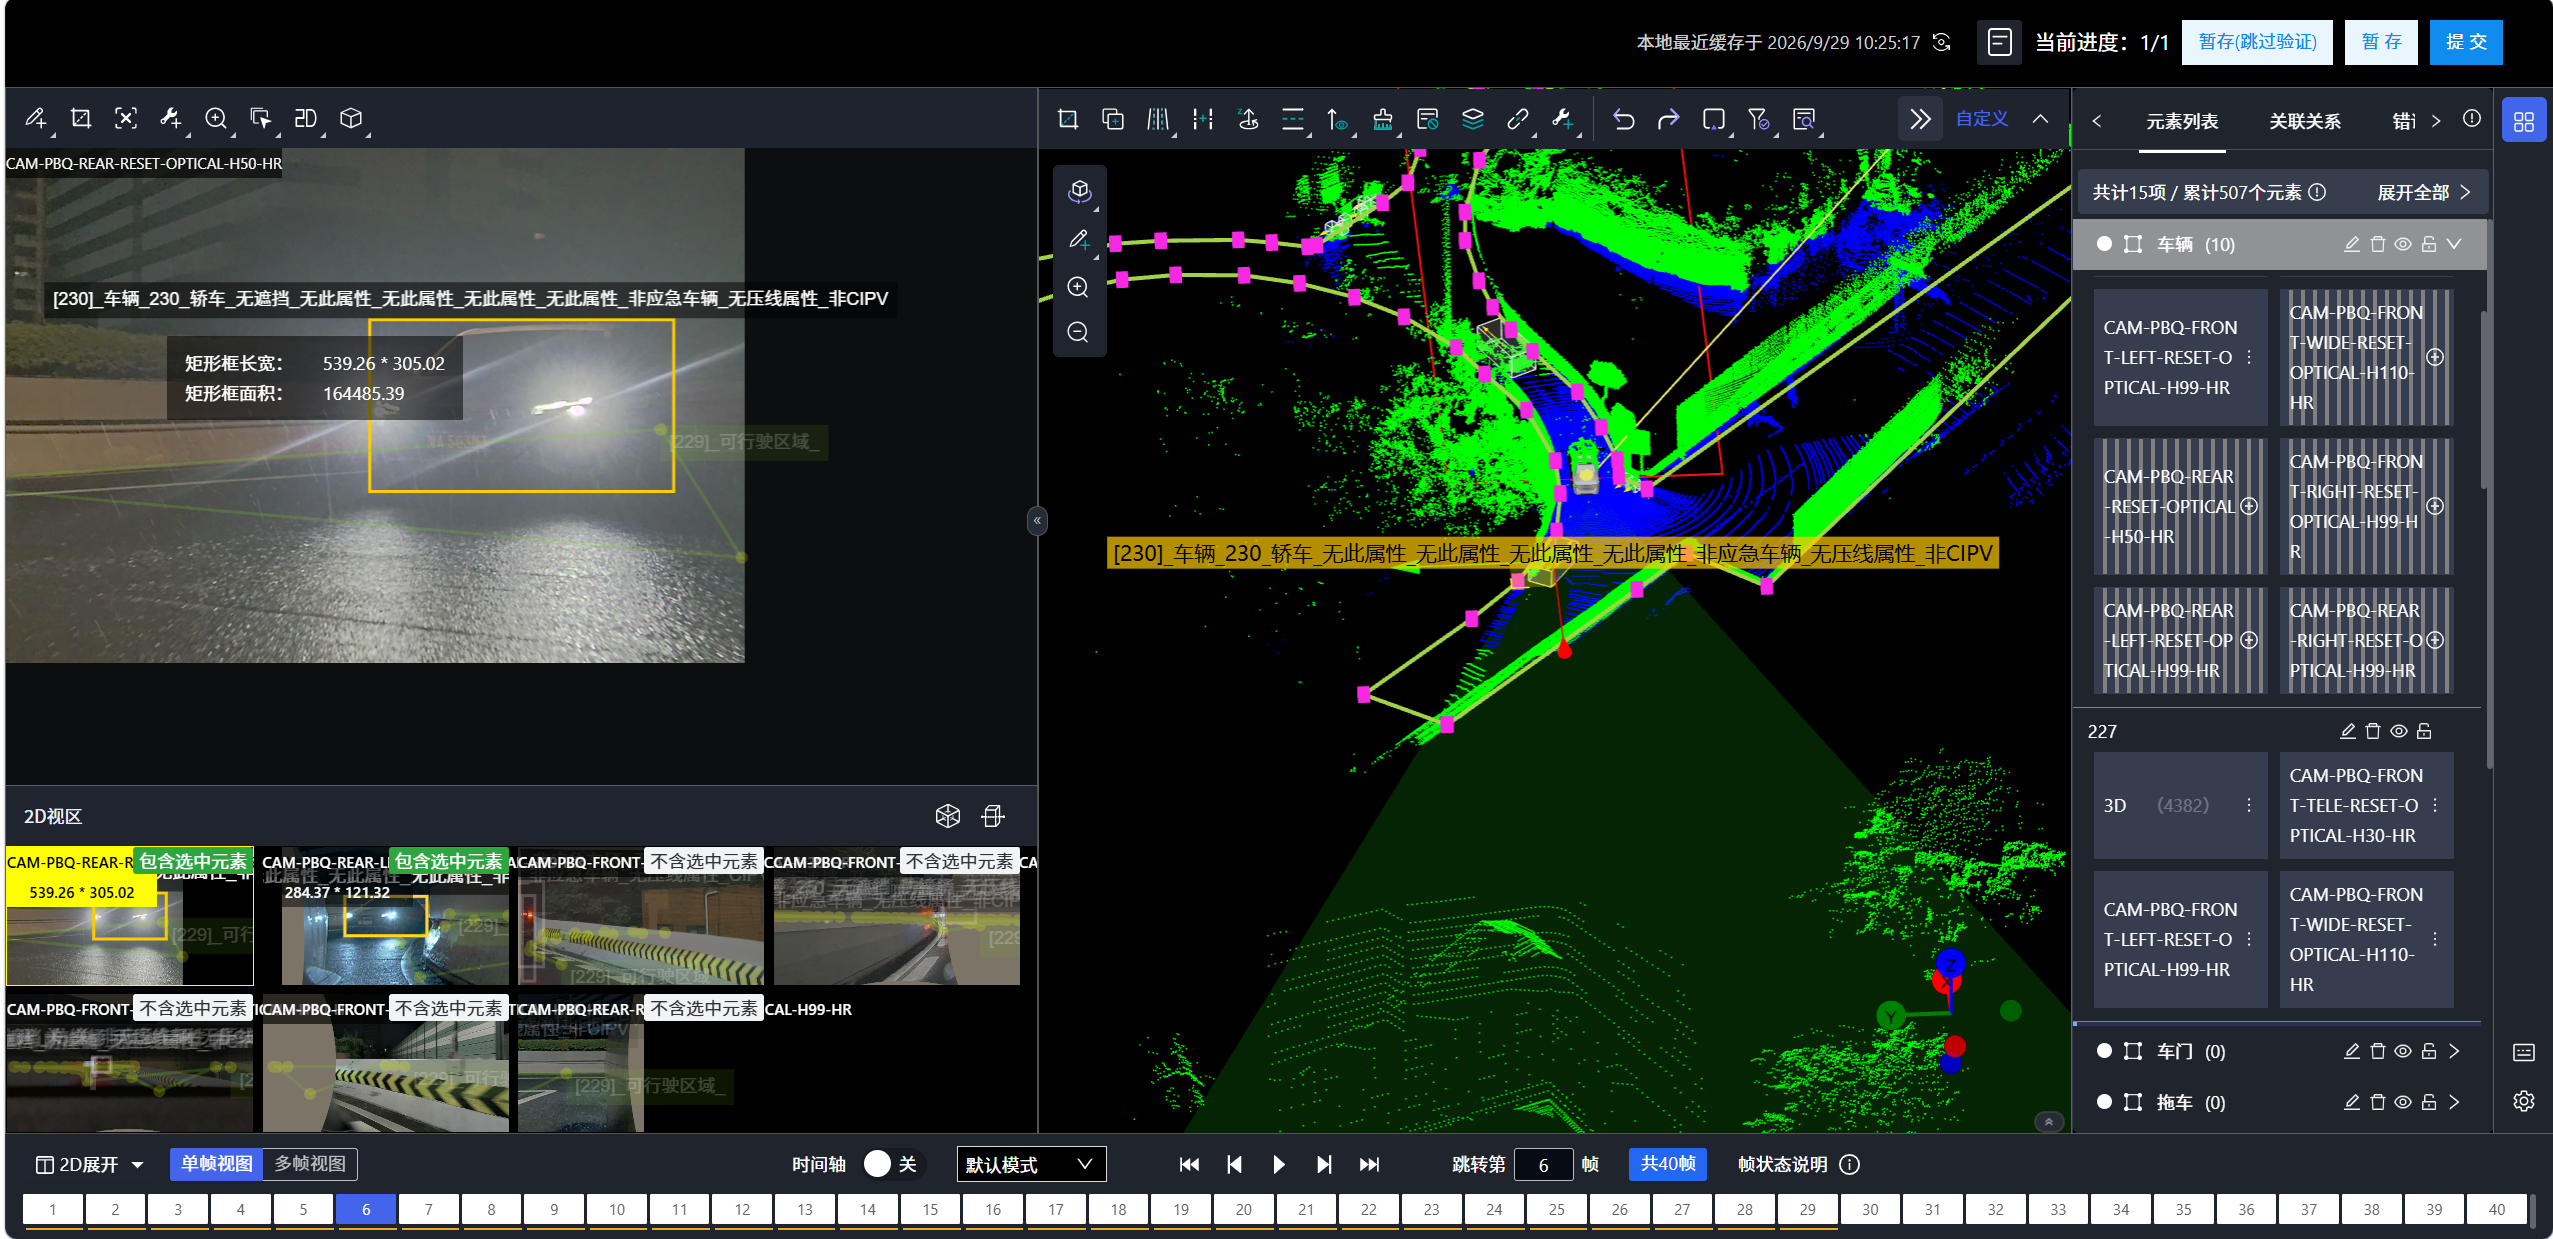
智能驾驶解决方案
感知算法训练的数据供给
围绕感知算法训练需求,提供二维 / 三维标注与点云处理,服务主流 ADAS 与自动驾驶功能场景。
- 标注2D / 3D 拉框 · 点云分割 · 目标跟踪 · BEV(待修改)
- 场景ACC · AEB · 城市 NOA · 自动泊车
- 数据摄像头 · 激光雷达点云 · 毫米波(待修改) · 多传感器融合(待修改)
- 质控初标—复核—抽检 三级质控 · 全流程可追溯
A / 04 · MULTIMODAL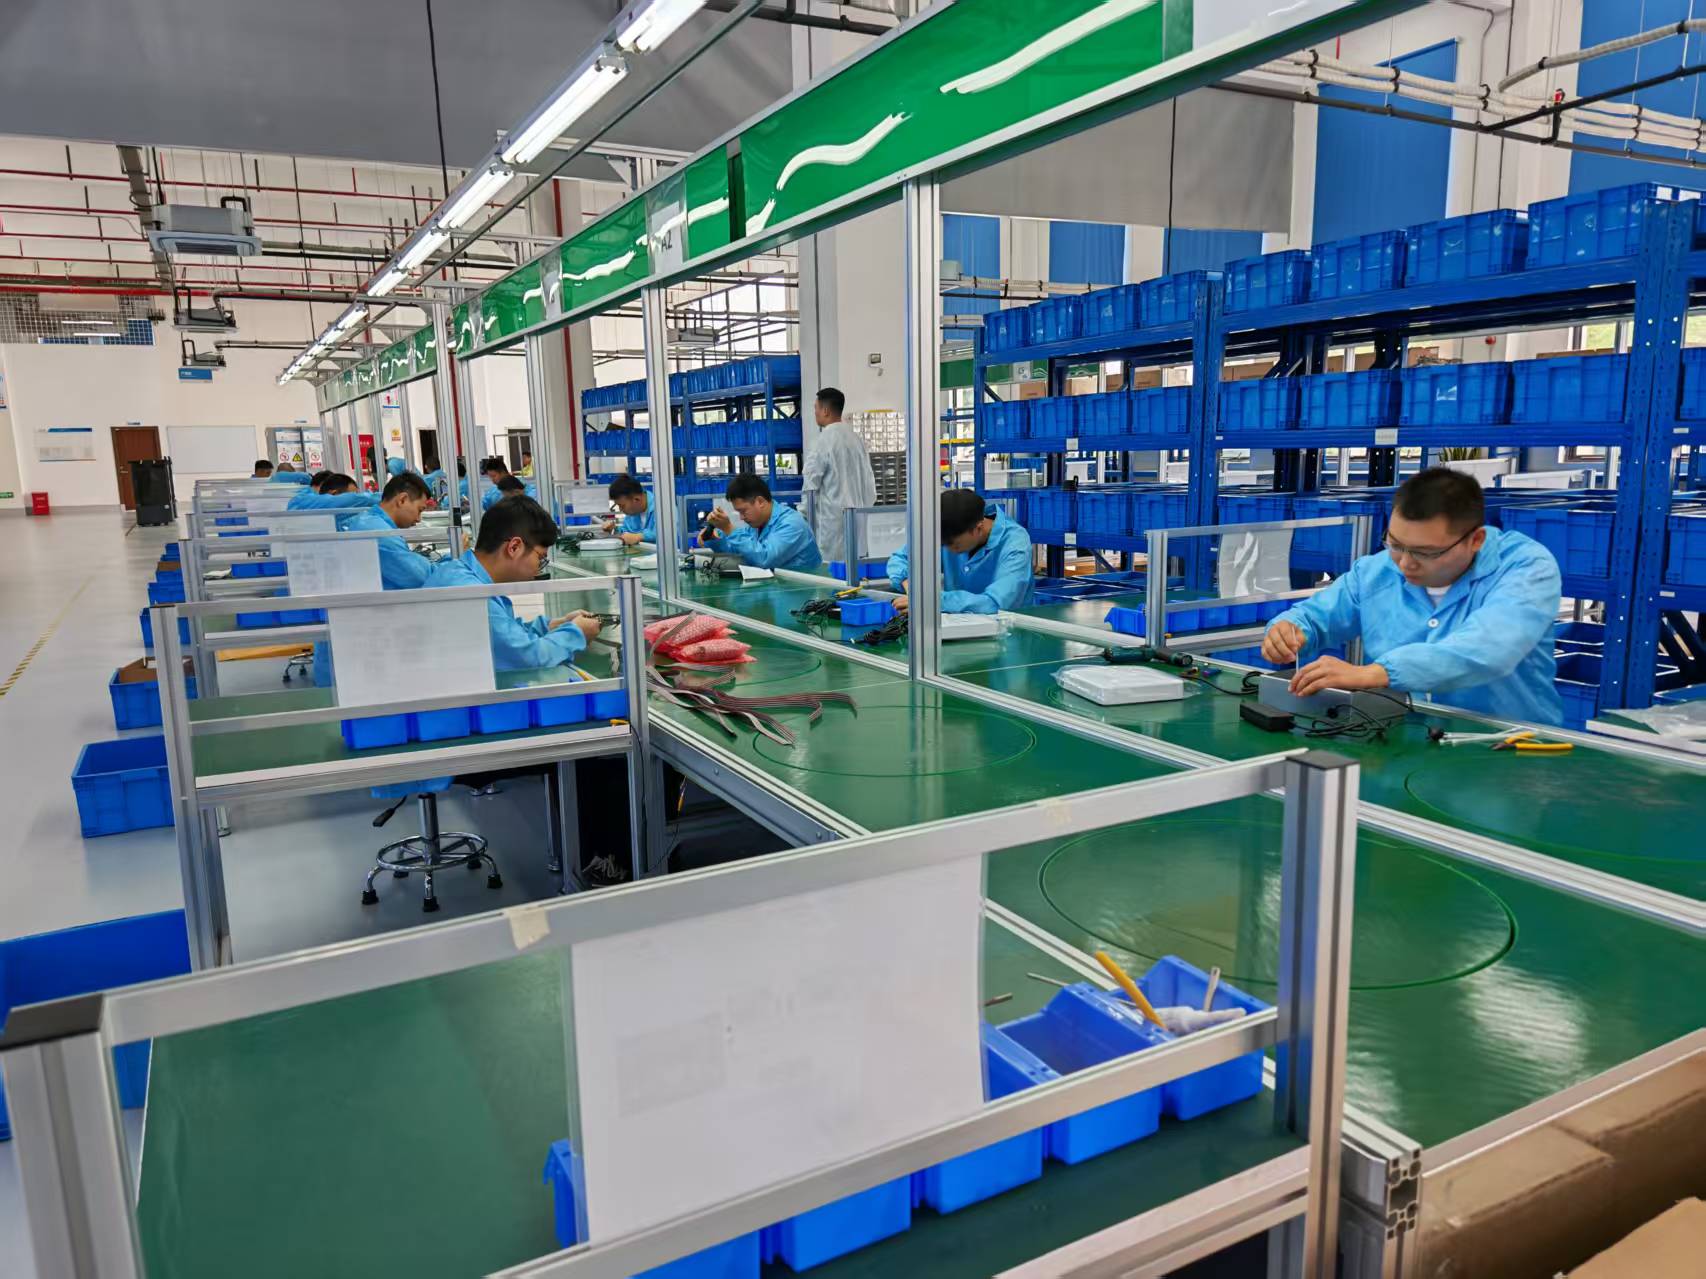
多模态数据服务
跨图像 · 视频 · 点云 · 音文本全品类
面向 VLM(待修改) / 多模态大模型的训练需求,跨图像、视频、点云、音文本进行全品类采集与加工。
- 品类图像 · 视频 · 点云 · 音文本 全品类
- 工序采集 → 清洗 → 标注 → 质检 一体化
- 来源实景采集 + 仿真数据加工
- 交付对齐客户格式规范,支持定制字段与标签体系
T / 05 · AIGC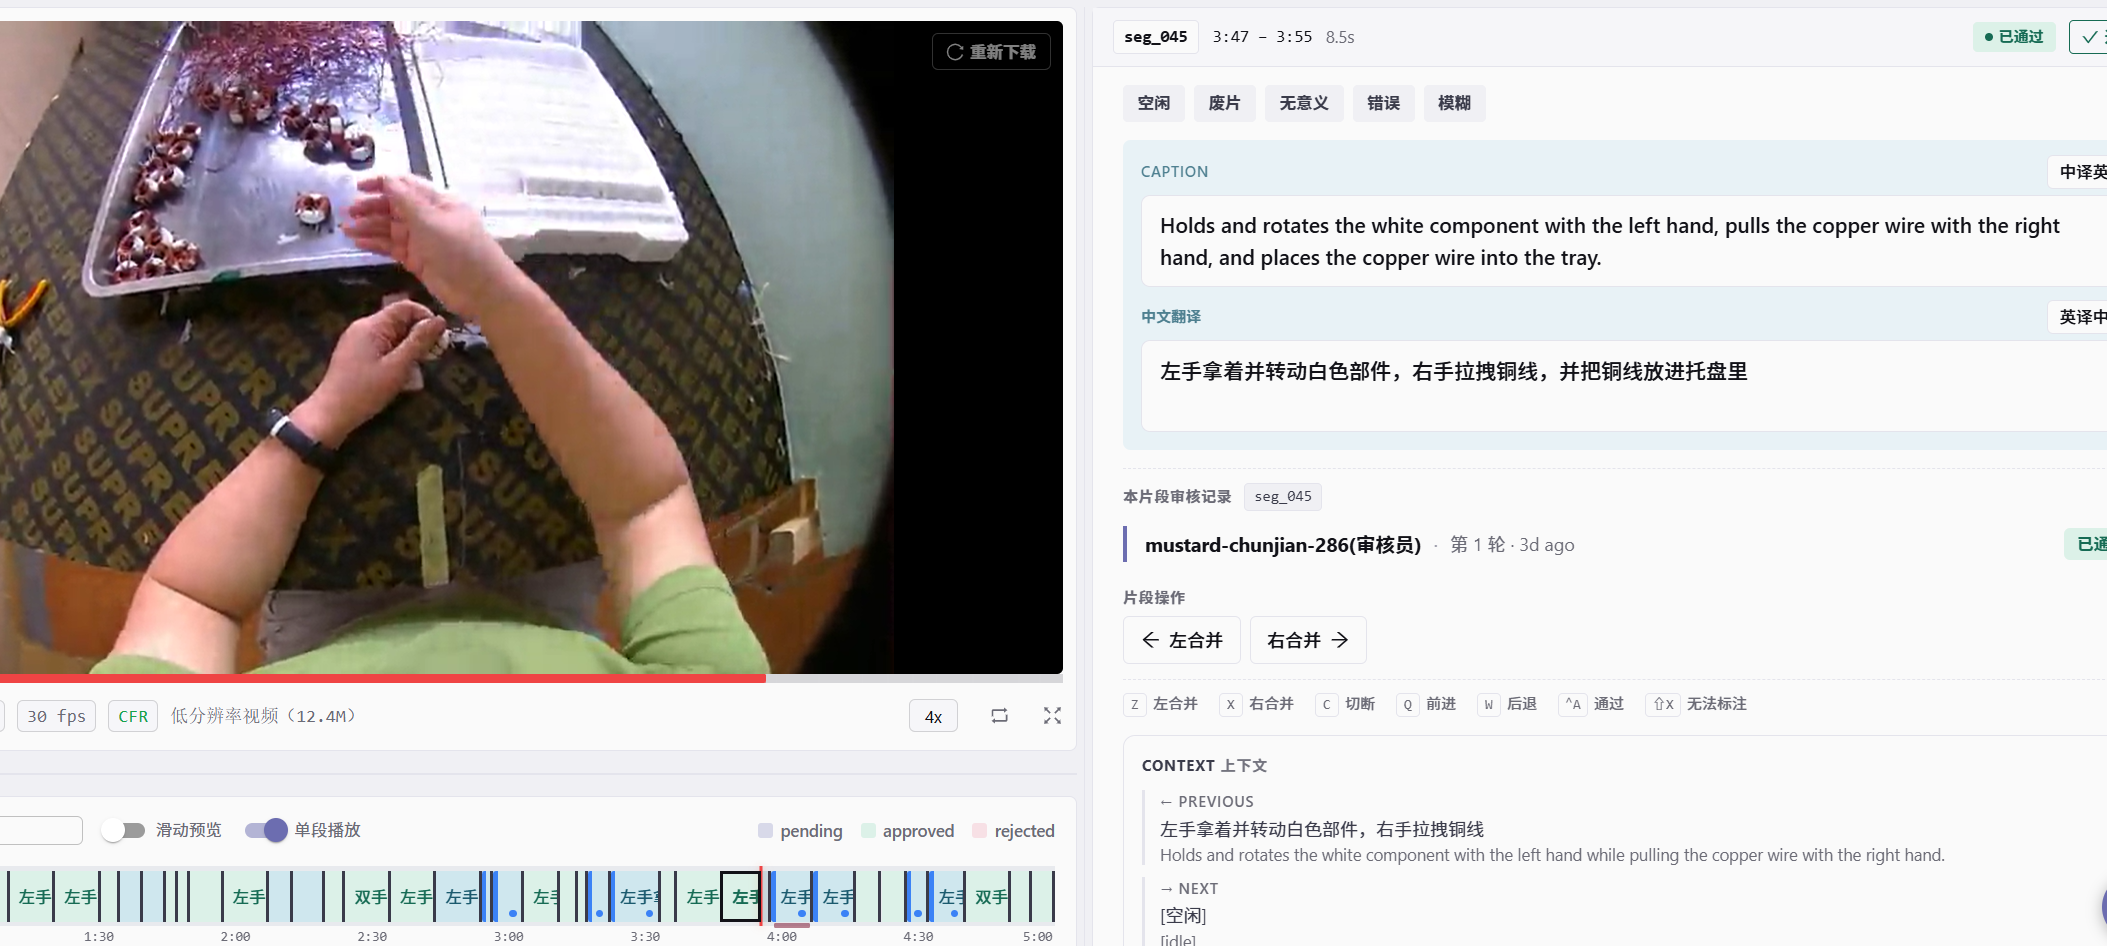
AIGC 标注与评测
面向生成式模型的训练与对齐
面向生成式模型的训练与对齐,提供视频精细化标注、内容评测与人工反馈类数据(待修改)服务。
- 标注视频精细化标注 · 描述生成 · 多语种视频标注
- 对齐Prompt 构建 · 人机对抗 · 效果测评
- 产能年标注产能 500 万条 · 月均交付 5 万+ 小时
- 质控标注准确率 95%+
B / 06 · CAMPUS BPO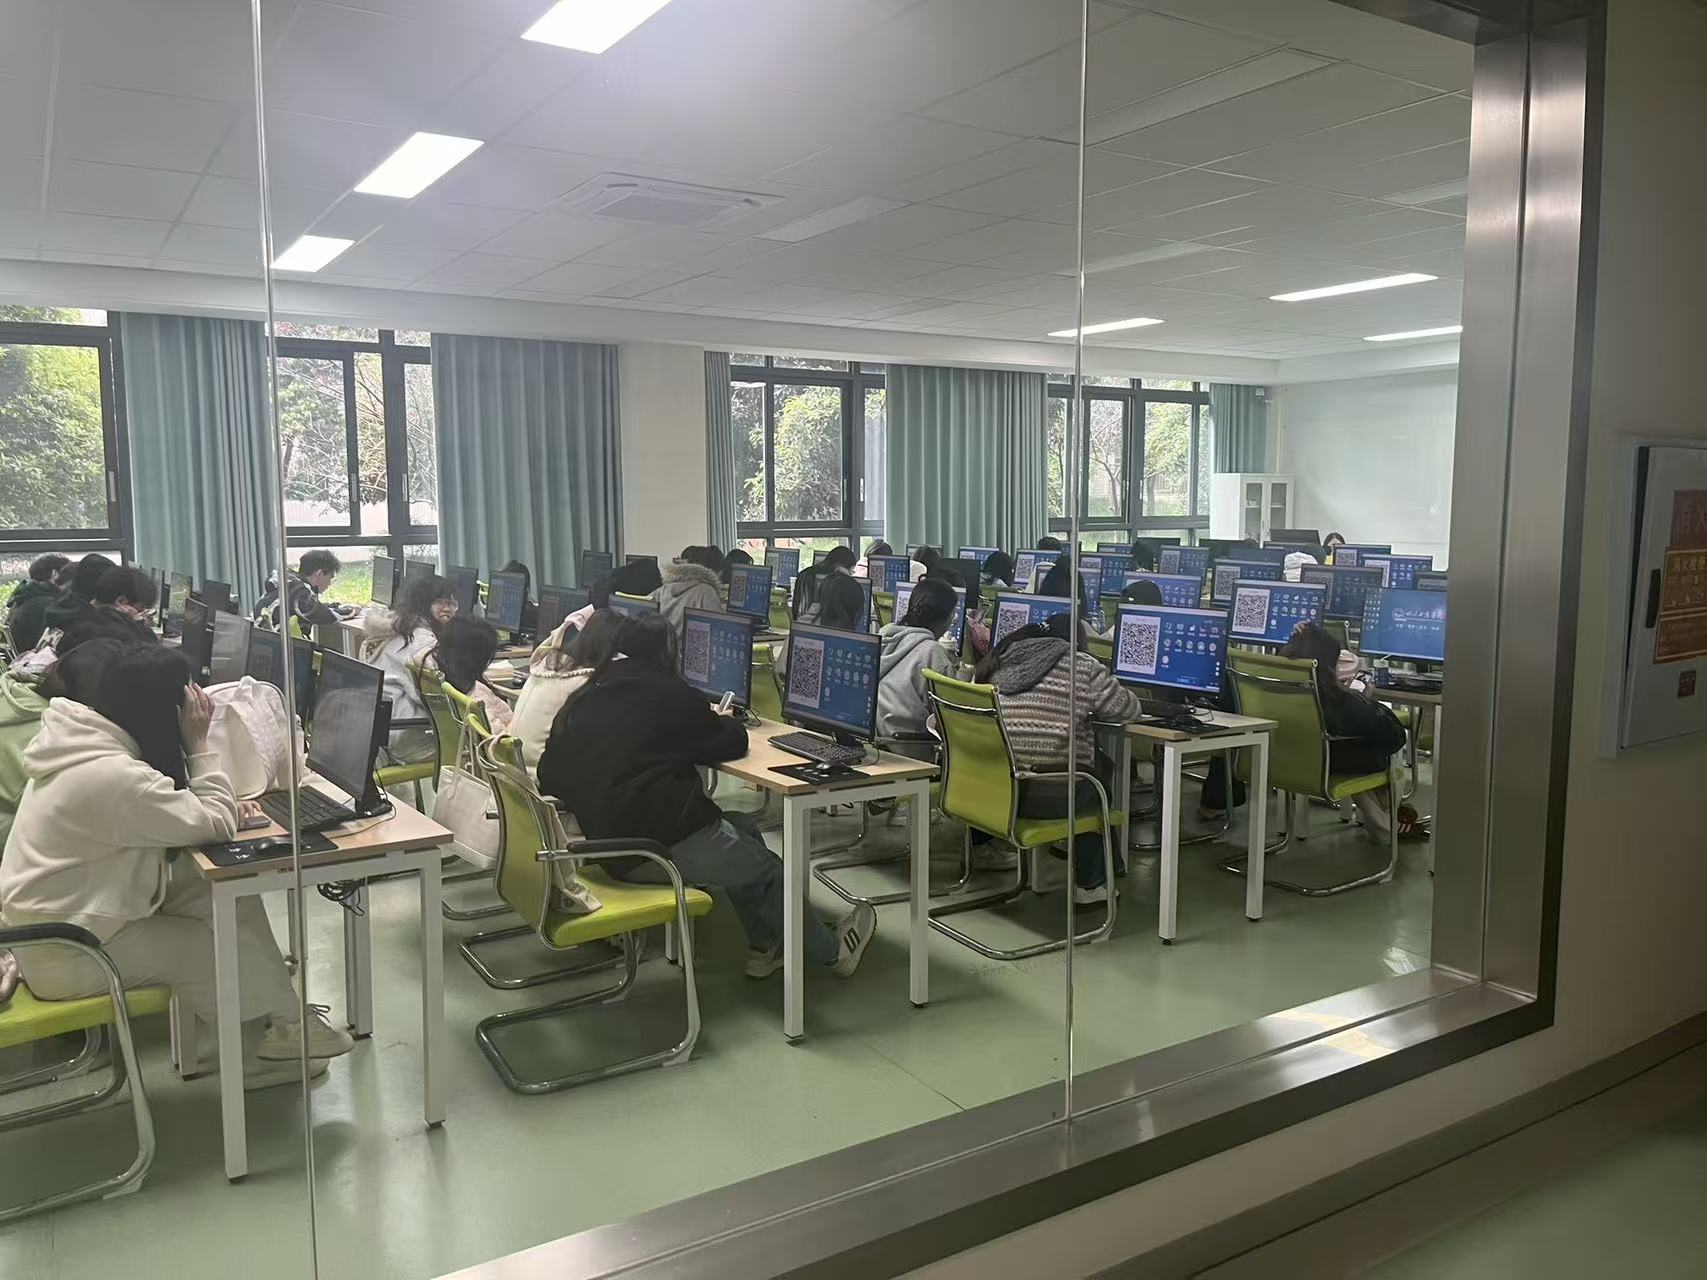
校园 BPO 外包
产教融合式的规模化标注产能
依托四川高校网络,以产教融合方式承接规模化标注外包,兼顾成本、弹性与质量。
- 网络四川 8 所本专科高校
- 人力1,000+ 储备弹性人力
- 闭环接单 — 分单 — 实训 — 质检
- 样本四川城市职业学院 · 四川工商学院 等项目复用